Toate aparițiile unui subșir de caractere în C++
Caută un model în text și păstrează inclusiv aparițiile suprapuse. Verifică ultima poziție validă, modelul prea lung și indexarea de la zero.
În acest material
Modelul ana apare de două ori în banana, la indicii 1 și 3 dacă numărăm de la zero. Cele două apariții se suprapun în litera a de pe indicele 3. O căutare a tuturor aparițiilor trebuie să precizeze dacă acceptă asemenea suprapuneri; aici le acceptăm.
Potrivire consecutivă, nu litere alese
Prin subșir de caractere în această lecție înțelegem un fragment consecutiv al textului, numit și substring. Nu putem sări peste litere. Modelul bna nu apare consecutiv în banana, deși literele pot fi alese în această ordine.
Citim două linii de litere mici a..z: textul de lungime 0..1000 și modelul de lungime 1..100. Afișăm numărul aparițiilor, apoi indicii lor pe a doua linie. Pentru nicio apariție, a doua linie este goală. Modelul gol este exclus explicit, deoarece ar cere o convenție separată.
Încercăm fiecare început posibil
Dacă modelul are m caractere, un început i este valid numai când i+m≤n. Pentru fiecare asemenea i, comparăm text[i+j] cu model[j], de la j=0. Prima diferență oprește încercarea. Dacă j ajunge la m, am verificat toate caracterele și salvăm i.
După o potrivire avansăm începutul doar cu unu, nu cu m. Astfel găsim și aparițiile suprapuse. Pentru aaaa și modelul aa, începuturile sunt 0,1,2.
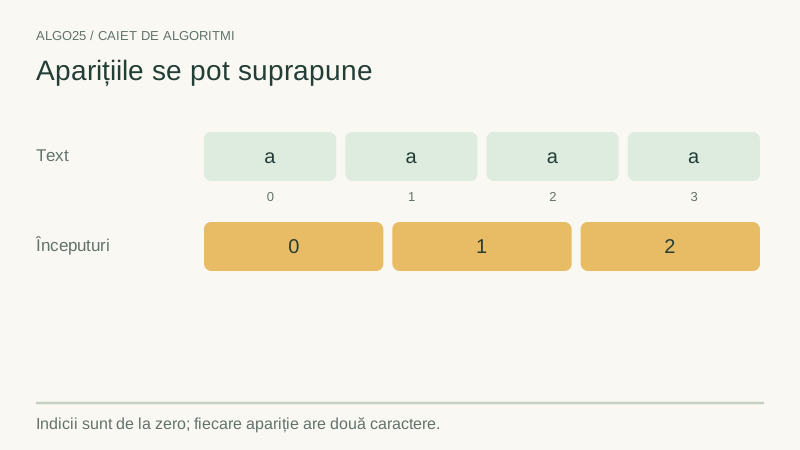 În aaaa, modelul aa începe la indicii 0,1,2. După o apariție, avansarea cu o poziție păstrează suprapunerile.Mărește schema ↗
Varianta cu char[]
#include <iostream>
#include <cstring>
using namespace std;
int main() {
    char text[1001],model[101];
    cin.getline(text,1001); cin.getline(model,101);
    int n=static_cast<int>(strlen(text)),m=static_cast<int>(strlen(model));
    int pozitii[1001],k=0;
    for(int i=0;i+m<=n;++i) {
        int j=0;
        while(j<m && text[i+j]==model[j]) ++j;
        if(j==m) pozitii[k++]=i;
    }
    cout << k << '\n';
    for(int i=0;i<k;++i) cout << (i?" ":"") << pozitii[i];
    cout << '\n';
}
Varianta echivalentă cu std::string
Păstrăm aceleași limite și exemple. Șirul clasic rezervă spațiu inclusiv pentru terminatorul nul; obiectul string își gestionează memoria. Indicii caracterelor utile pornesc de la zero în ambele variante.
#include <string>

#include <iostream>
#include <vector>
using namespace std;
int main() {
    string text,model;
    getline(cin,text); getline(cin,model);
    int n=static_cast<int>(text.size()),m=static_cast<int>(model.size());
    vector<int> pozitii(n+1); int k=0;
    for(int i=0;i+m<=n;++i) {
        int j=0;
        while(j<m && text[i+j]==model[j]) ++j;
        if(j==m) pozitii[k++]=i;
    }
    cout << k << '\n';
    for(int i=0;i<k;++i) cout << (i?" ":"") << pozitii[i];
    cout << '\n';
}
Ultima poziție trebuie inclusă
Pentru n=6 și m=3, ultimul început posibil este 3, deoarece acoperă indicii 3,4,5. Condiția strictă i+m<n l-ar omite. Când m>n, bucla nu pornește și nu există acces în afara textului.
Capacitățile 1001 și 101 includ terminatorii nuli ai șirurilor clasice. Tabloul de poziții are suficient loc deoarece un model nevid poate începe în cel mult n locuri. Varianta string folosește un vector pentru poziții, fără să schimbe rezultatele sau indexarea.
Metoda este naivă în sensul că reia comparațiile pentru fiecare început. În cel mai rău caz face O(n·m) comparații și păstrează O(n) poziții. Este potrivită pentru limitele didactice alese; texte foarte mari pot cere un algoritm specializat.
Exersează
banana cu ana produce indicii 1 și 3. aaaa cu aa produce 0,1,2. Testează modelul egal cu întregul text, modelul prea lung și textul gol. Construiește și o potrivire aflată numai la ultima poziție validă.
Continuă cu funcțiile de căutare în șiruri, reprezentarea textului și complexitatea.
Întrebări frecvente
Se numără și aparițiile suprapuse ale unui fragment?
Da în această lecție. Fragmentul ana apare în banana la indicii 1 și 3, cu o literă comună. Oprirea sau avansarea prea mult după prima potrivire ar pierde a doua apariție.
Cu cât avansez după o potrivire dacă permit suprapuneri?
Continuă căutarea de la poziția de început a potrivirii plus unu. Avansarea cu întreaga lungime a modelului ar sări peste unele potriviri suprapuse.
Un substring poate sări peste caractere din text?
Nu. Un substring este un fragment consecutiv. Alegerea unor caractere în ordine, dar cu salturi, descrie un alt tip de subșir și necesită o altă verificare.
Un pas mai departe
Autentifică-te pentru a păstra progresul în cont.