Compresia RLE: grupuri de caractere egale în C++
Codifică grupurile consecutive de litere prin caracter și lungime. Înțelege RLE, diferența față de frecvențe și cazurile fără compresie reală.
În acest material
Textul aaabbcaa poate fi descris prin grupurile a:3 b:2 c:1 a:2. Litera a apare în două grupuri separate, deoarece între ele există alte caractere. Această descriere se numește RLE, de la Run-Length Encoding, adică reprezentare prin lungimea grupurilor consecutive.
Formatul este parte din cerință
Citim o linie cu cel mult 1000 de litere mici a..z. Acceptăm și textul gol. Pentru fiecare grup afișăm litera, două puncte și numărul aparițiilor consecutive, separând grupurile printr-un spațiu. Textul gol produce o linie goală.
Formatul explicit elimină ambiguitatea dintre litere și numărări. Nu afirmăm că ieșirea este mereu mai scurtă: pentru abc, forma a:1 b:1 c:1 este mai lungă. Aici învățăm reprezentarea și detectarea grupurilor, nu proiectăm un format de arhivare universal.
Două frontiere pentru același grup
Indicele i marchează primul caracter al grupului. Pornim j de la i+1 și îl avansăm cât timp întâlnim aceeași literă. Intervalul i..j-1 conține exact grupul curent, iar lungimea lui este j-i. Afișăm grupul și mutăm i direct la j, începutul următorului.
Când ultimul grup ajunge până la sfârșitul textului, j devine n. Nu citim s[n] în condiția de egalitate, deoarece verificăm mai întâi j<n. Astfel același mecanism tratează și un text alcătuit dintr-o singură literă repetată.
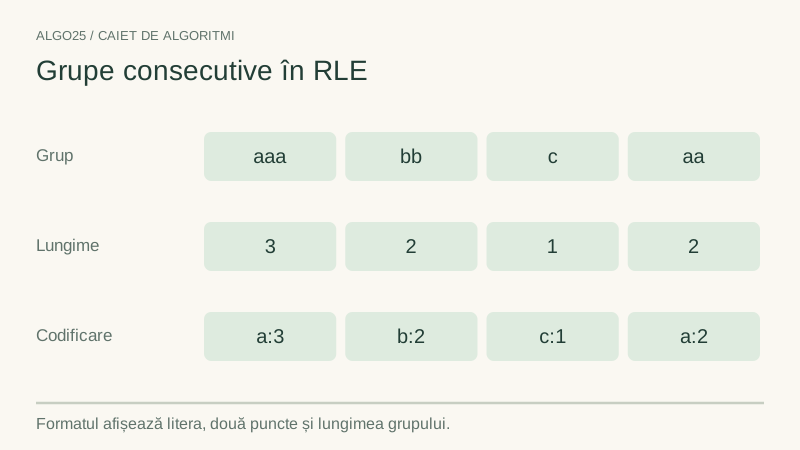 Textul aaabbcaa formează grupurile aaa,bb,c,aa, codificate exact a:3 b:2 c:1 a:2. Cele două grupuri de a rămân separate.Mărește schema ↗
Varianta cu char[]
#include <iostream>
#include <cstring>
using namespace std;
int main() {
    char s[1001]; cin.getline(s,1001);
    int n=static_cast<int>(strlen(s));
    int i=0; bool primul=true;
    while(i<n) {
        int j=i+1;
        while(j<n && s[j]==s[i]) ++j;
        if(!primul) cout << ' ';
        cout << s[i] << ':' << j-i;
        primul=false; i=j;
    }
    cout << '\n';
}
Varianta echivalentă cu std::string
Păstrăm aceleași limite și exemple. Șirul clasic rezervă spațiu inclusiv pentru terminatorul nul; obiectul string își gestionează memoria. Indicii caracterelor utile pornesc de la zero în ambele variante.
#include <string>

#include <iostream>

using namespace std;
int main() {
    string s; getline(cin,s);
    int n=static_cast<int>(s.size());
    int i=0; bool primul=true;
    while(i<n) {
        int j=i+1;
        while(j<n && s[j]==s[i]) ++j;
        if(!primul) cout << ' ';
        cout << s[i] << ':' << j-i;
        primul=false; i=j;
    }
    cout << '\n';
}
Frecvența totală pierde ordinea grupurilor
Pentru aba, un vector de frecvență ar spune că a apare de două ori și b o dată. Din aceste numere nu poți reconstrui dacă textul a fost aba, aab sau baa. RLE păstrează ordinea grupurilor și produce a:1 b:1 a:1, suficientă pentru reconstrucția exemplului.
Tabloul char are capacitatea 1001, incluzând terminatorul nul de după cel mult 1000 de litere. Conversia lungimii la int este justificată de această limită. Varianta string păstrează același alfabet și aceleași intrări de test.
Fiecare caracter aparține unui singur grup și este traversat un număr constant de ori. Timpul este O(L), unde L este lungimea textului. Starea suplimentară ocupă O(1) memorie, deoarece rezultatul este afișat pe măsură ce grupurile sunt identificate.
Exersează
Pentru aaabbcaa obții a:3 b:2 c:1 a:2. Pentru aaaa obții a:4, iar pentru ab obții a:1 b:1. Ca extensie, descrie decodificarea: pentru fiecare pereche, afișezi litera de numărul indicat de ori. Verifică limitele ieșirii înainte de a aloca un tablou pentru ea.
Revezi parcurgerea textului, grupurile de cuvinte și vectorii de frecvență.
Întrebări frecvente
Ce înseamnă RLE?
RLE vine de la Run-Length Encoding și reprezintă grupurile de caractere consecutive prin caracter și lungimea grupului. De exemplu, aaabbcaa devine a:3 b:2 c:1 a:2 în formatul lecției.
De ce apar două grupuri pentru aceeași literă în RLE?
Grupurile sunt consecutive. În aaabbcaa, cele două apariții finale ale lui a sunt separate de primul grup prin alte litere, deci nu se unesc cu el.
RLE produce întotdeauna un text mai scurt?
Nu. Dacă grupurile sunt scurte, caracterele care descriu lungimile și separatorii pot mări rezultatul. Avantajul depinde de date și de formatul exact de codificare.
Un pas mai departe
Autentifică-te pentru a păstra progresul în cont.