Operații pe șiruri C++: comparare și palindrom
Compară și parcurge șiruri în C++. Verifică un palindrom cu char[] și std::string, înțelegând indicii, terminatorul nul și cazurile particulare.
În acest material
Operațiile pe șiruri pornesc de la aceeași întrebare ca la tablouri: ce caractere trebuie citite sau modificate și care sunt indicii lor valizi? O reprezentare comodă nu înlocuiește limitele algoritmului. În această lecție verificăm dacă un text se citește identic de la stânga la dreapta și invers.
Înainte, parcurge reprezentarea și citirea textului. Exemplele folosesc ASCII și compară exact caracterele, inclusiv spațiile și diferențele dintre litere mari și mici. Astfel, ana este palindrom, dar Ana nu este în convenția noastră.
Compararea textului
Pentru două obiecte std::string, a == b verifică egalitatea conținutului. Pentru tablouri clasice de caractere nu folosi a == b pentru această cerință: expresia nu compară literele șirurilor. Funcția std::strcmp(a, b) din <cstring> compară două șiruri terminate corect cu zero.
Rezultatul lui strcmp este zero pentru texte egale, negativ dacă primul precedă al doilea și pozitiv în situația inversă. Nu presupune că valorile nenule sunt exact -1 sau 1. Ordinea este lexicografică, bazată pe caractere, deci compararea textelor "10" și "2" nu este compararea numerelor 10 și 2.
Pentru copiere într-un tablou clasic ai nevoie de capacitate suficientă, inclusiv pentru terminator. Funcții precum strcpy și strcat nu primesc capacitatea destinației și nu o verifică pentru tine. La început este mai simplu să urmărești explicit indicii și numărul de poziții necesare, înainte de a folosi asemenea operații.
Două capete care se apropie
Un palindrom are primul caracter egal cu ultimul, al doilea egal cu penultimul și așa mai departe. Pornim cu stanga = 0 și dreapta = n - 1. Dacă găsim o pereche diferită, răspunsul este imediat negativ. Altfel, creștem capătul stâng și îl micșorăm pe cel drept.
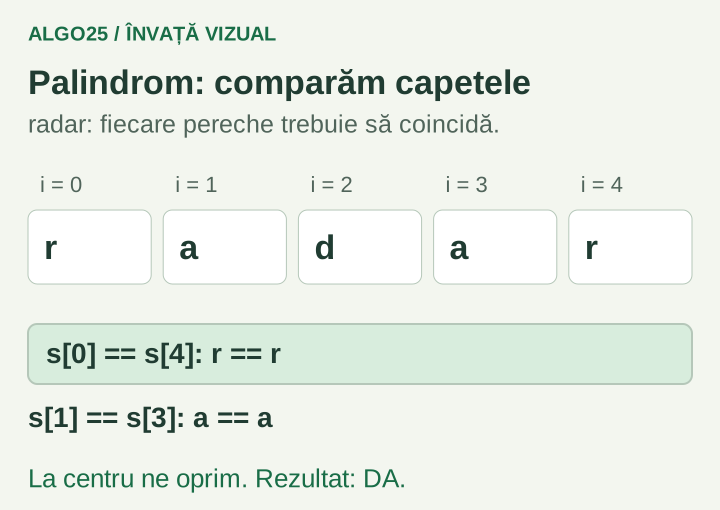 Comparațiile se opresc când cei doi indici se întâlnesc sau se depășesc.
Nu trebuie să construim textul inversat. Condiția stanga < dreapta evită compararea inutilă a centrului și previne repetarea acelorași perechi. Pentru o lungime impară rămâne un singur caracter central; acesta este întotdeauna egal cu el însuși.
Program complet
Citim o linie de cel mult 200 de caractere ASCII imprimabile. Afișăm DA dacă linia este palindrom și NU în caz contrar. Considerăm și linia goală palindrom: nu există nicio pereche care să încalce egalitatea cerută.
Varianta cu tablou clasic char[]
Calculăm lungimea o singură dată cu strlen. Conversia la int este sigură în limita de 200 de caractere. Astfel, pentru textul gol putem folosi capătul drept -1, fără scădere pe un tip fără semn.
#include <iostream>
#include <cstring>
int main() {
    char s[201]{};
    std::cin.getline(s, 201);
    int n = static_cast<int>(std::strlen(s));
    int stanga = 0, dreapta = n - 1;
    bool palindrom = true;
    while (stanga < dreapta) {
        if (s[stanga] != s[dreapta]) {
            palindrom = false;
            break;
        }
        ++stanga;
        --dreapta;
    }
    std::cout << (palindrom ? "DA" : "NU") << '\n';
    return 0;
}
Varianta cu std::string
Folosim aceeași lungime cu semn, aceiași indici și aceeași condiție. Metoda size() înlocuiește strlen, iar citirea folosește std::getline. Nu schimbăm sensul cerinței odată cu reprezentarea textului.
#include <iostream>
#include <string>
int main() {
    std::string s;
    std::getline(std::cin, s);
    int n = static_cast<int>(s.size());
    int stanga = 0, dreapta = n - 1;
    bool palindrom = true;
    while (stanga < dreapta) {
        if (s[stanga] != s[dreapta]) {
            palindrom = false;
            break;
        }
        ++stanga;
        --dreapta;
    }
    std::cout << (palindrom ? "DA" : "NU") << '\n';
    return 0;
}
Corectitudine și cost
După fiecare pas reușit, toate perechile aflate în exteriorul intervalului rămas sunt egale. Dacă apare o nepotrivire, ea este suficientă pentru a respinge întregul text. Dacă indicii se întâlnesc ori se depășesc, toate perechile necesare au fost verificate și răspunsul este afirmativ.
Comparăm cel mult jumătate din caractere, deci verificarea are timp O(n) în cazul cel mai rău și O(1) spațiu suplimentar față de text. Citirea și măsurarea textului clasic sunt tot liniare. Nu pune strlen(s) în condiția unei bucle care îl recalculează la fiecare pas: ai transforma inutil o parcurgere liniară într-una cu cost pătratic.
Dacă enunțul ar cere ignorarea spațiilor sau a literelor mari, ar fi o altă problemă și ar trebui formulată explicit regula de normalizare. Nici inversarea octeților dintr-un text UTF-8 nu este o metodă corectă de inversare generală a literelor Unicode. Limita ASCII ne permite aici să legăm direct fiecare caracter de un indice.
Exersează
- Ce răspuns obținem pentru
abba? Dar pentruabca? - Câte comparații sunt necesare pentru
radar? - De ce nu comparăm
s[0]cus[n]? - Cum modifici algoritmul pentru a număra perechile diferite?
Răspunsuri: DA, respectiv NU; două; n - 1 este ultimul indice al textului, iar în tabloul clasic s[n] este terminatorul; păstrezi un contor și continui după fiecare nepotrivire, în loc să oprești bucla.
Continuă cu prelucrarea cuvintelor.
Un pas mai departe
Se încarcă progresul…